จัดลำดับใบสั่งงานในโรงงานเซมิคอนดักเตอร์ด้วย Random Forest
สรุปงานวิจัยปริญญาโท: ข้อมูลการผลิต 4 ล้านแถว เทียบสามโมเดล และการนำไปใช้จริง
เผยแพร่
งานวิจัยปริญญาโทของผมเริ่มจากปัญหาที่เห็นทุกวันในโรงงานเซมิคอนดักเตอร์ คือใบสั่งงานถูกจัดเข้าเครื่องจักรไม่สอดคล้องกับกำลังการผลิตของแต่ละเครื่อง ทำให้เกิดคอขวด งานรอนาน และเครื่องบางตัวว่างขณะที่บางตัวล้น คำถามวิจัยจึงเรียบง่าย ถ้าเราทำนายได้ล่วงหน้าว่าใบสั่งงานแต่ละใบจะไปที่ขั้นตอนไหนและใช้เวลาเท่าไร เราจะจัดลำดับงานได้ดีขึ้นแค่ไหน
บทความนี้เล่าแนวทางที่ผมใช้ทั้งกระบวนการ แบ่งเป็นสามช่วง คือ สร้าง วิเคราะห์ และจัดทำเพื่อใช้งานจริง ตามภาพด้านบน
ช่วงที่ 1 สร้าง: จากข้อมูลดิบสู่ชุดข้อมูลที่ใช้ได้
ข้อมูลมาจากฐานข้อมูล PostgreSQL ของระบบการผลิตย้อนหลัง 2 ปี ตั้งต้น 17,953,082 แถว หลังคัดกรองเหลือ 4,052,934 แถว แบ่งเป็นชุดฝึก 2,837,053 แถว และชุดทดสอบ 1,215,881 แถว
| ขั้น | สิ่งที่ทำ | เหตุผล |
|---|---|---|
| คัดกรอง | ตัดแถวที่ไม่ครบหรือผิดปกติ | ข้อมูลผิดทำให้โมเดลเรียนผิด |
| แปลงค่า | Label Encoding ข้อความเป็นตัวเลข | โมเดลรับได้เฉพาะตัวเลข |
| ปรับสเกล | ทำให้ค่าแต่ละคอลัมน์อยู่ในช่วงเดียวกัน | กันไม่ให้คอลัมน์ที่ค่าสูงมีอิทธิพลเกินจริง |
| แบ่งชุด | ฝึก 70% ทดสอบ 30% | ทดสอบกับข้อมูลที่โมเดลไม่เคยเห็น |
ทั้งหมดทำเป็นขั้นตอนอัตโนมัติ 15 ขั้น ตั้งแต่โหลดค่าตั้งต้น ดึงข้อมูล ทำความสะอาด ฝึกแบบขนาน ประเมินผล ไปจนถึงบันทึกโมเดลและนำไปใช้ รันซ้ำได้ทุกครั้งที่มีข้อมูลใหม่
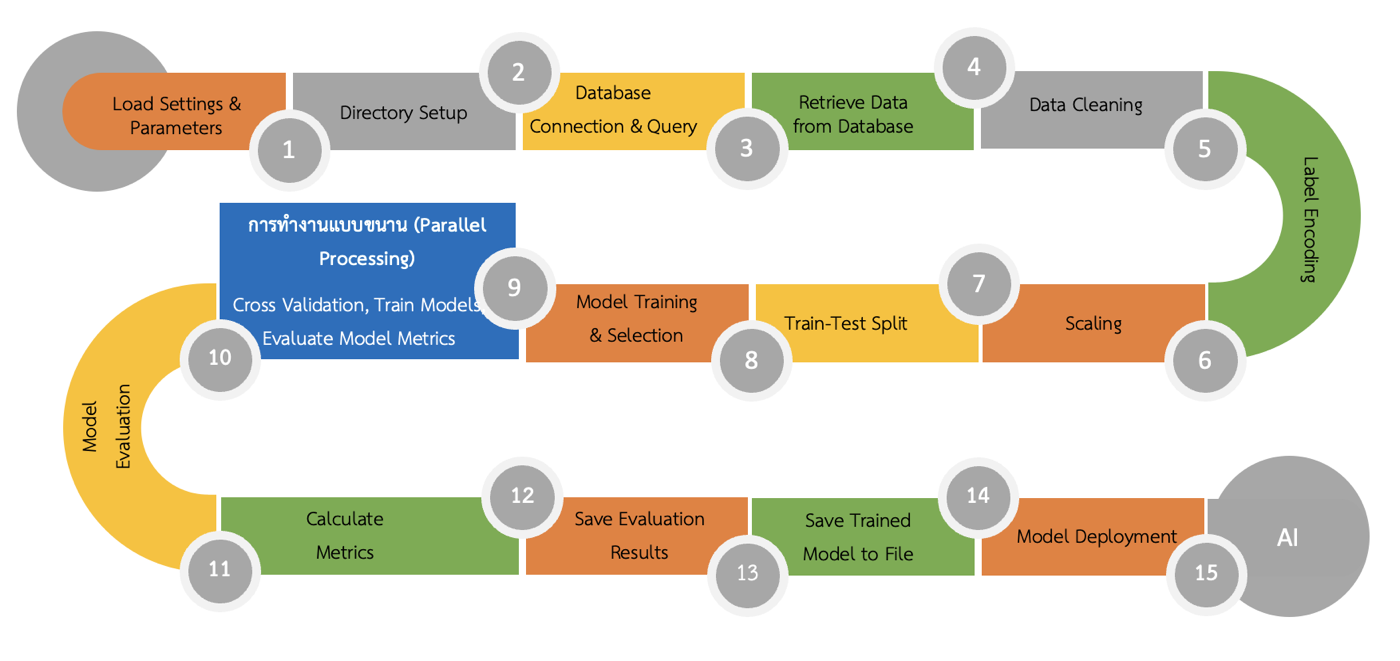
ภาพ: ขั้นตอนการสร้างและนำโมเดลไปใช้ 15 ขั้น ที่มา: ผู้เขียน (2568)
ช่วงที่ 2 วิเคราะห์: เทียบสามโมเดลอย่างยุติธรรม
ผมเลือกโมเดลสามแบบที่เหมาะกับข้อมูลแบบตาราง และประเมินด้วยตัวชี้วัดชุดเดียวกัน ไม่ดูแค่ความถูกต้อง เพราะข้อมูลการผลิตไม่สมดุล บางขั้นตอนเกิดบ่อย บางขั้นตอนนาน ๆ ครั้ง ค่า F1 เฉลี่ยทุกกลุ่มจึงบอกความจริงได้ดีกว่า
| โมเดล | ความถูกต้อง | Precision | Recall | F1 |
|---|---|---|---|---|
| Random Forest | 99.97% | 98.99% | 98.81% | 98.90% |
| Hist Gradient Boosting | 96.65% | 78.51% | 76.69% | 77.46% |
| Logistic Regression | 79.62% | 83.23% | 23.70% | 24.19% |
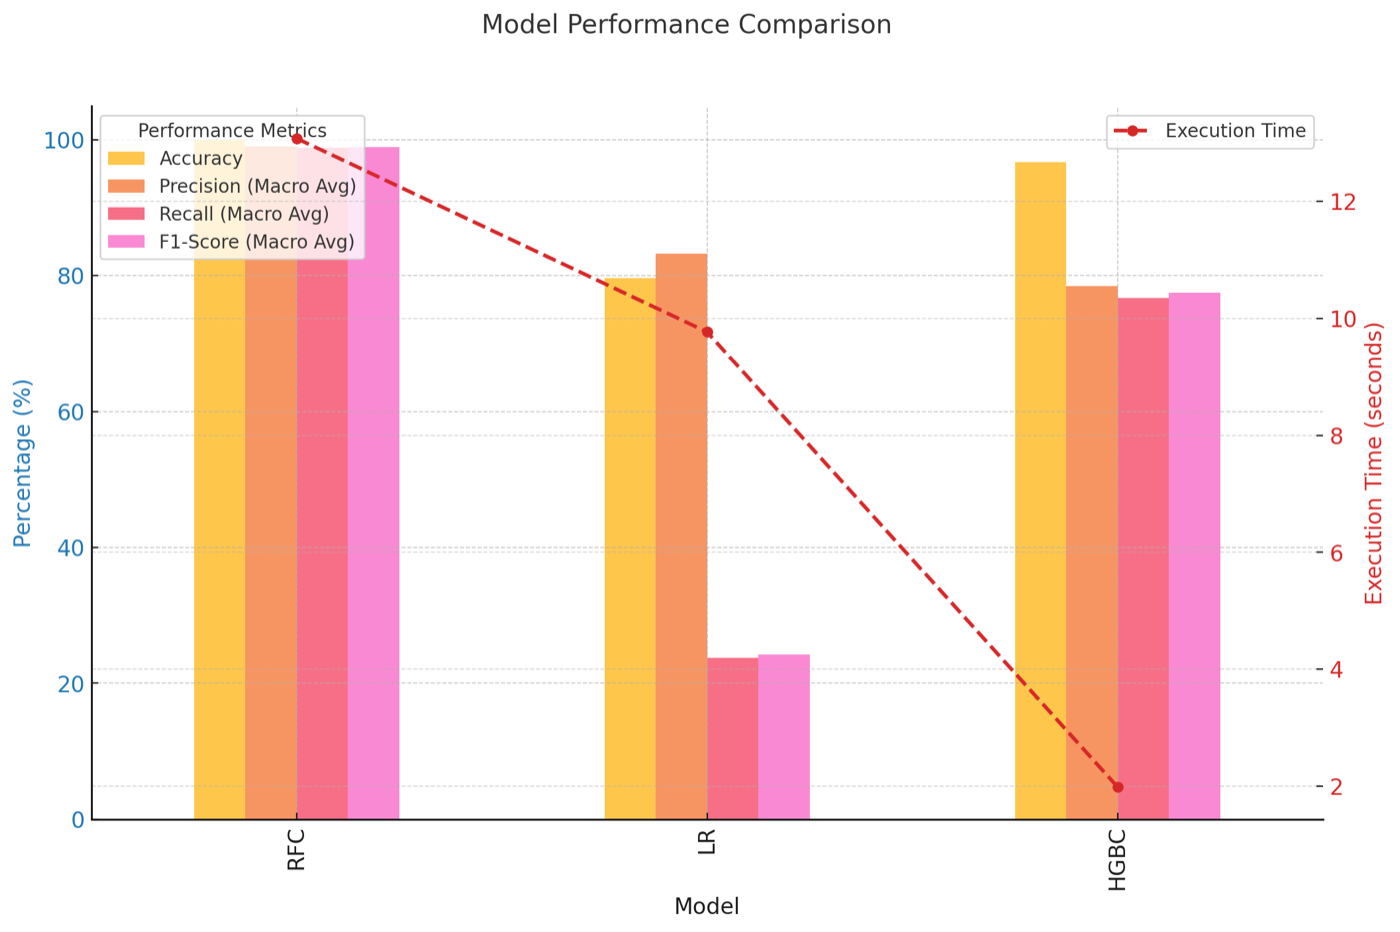
ภาพ: เปรียบเทียบตัวชี้วัดและเวลาประมวลผล ที่มา: ผู้เขียน (2568)
อ่านผลอย่างไร Logistic Regression ดูดีที่ความถูกต้อง 79.62% แต่ F1 เพียง 24.19% แปลว่าทายถูกแค่กลุ่มที่พบบ่อย Random Forest ได้ทั้งความถูกต้องและ F1 สูง และ cross-validation เฉลี่ย 99.96% ส่วนเบี่ยงเบนมาตรฐานเพียง 0.0000346 แปลว่าผลนิ่งในทุกชุดที่แบ่งตรวจ ข้อแลกเปลี่ยนคือใช้เวลาฝึกนานกว่า Hist Gradient Boosting ซึ่งยอมรับได้เพราะฝึกนอกเวลางาน
ทำไม Random Forest ข้อมูลการผลิตมีความสัมพันธ์ไม่เป็นเส้นตรงและไม่สมดุล ต้นไม้ตัดสินใจหลายร้อยต้นที่โหวตร่วมกันรับมือได้ดี ทนต่อค่าผิดปกติ และอธิบายได้ว่าคุณลักษณะไหนสำคัญ ซึ่งสำคัญมากเวลาต้องคุยกับวิศวกรหน้างาน
ช่วงที่ 3 จัดทำ: นำไปไว้ตรงที่คนทำงาน
โมเดลที่ดีที่สุดถูกบันทึกเป็นไฟล์ แล้วเปิดให้ระบบอื่นเรียกใช้ผ่าน Scheduler API ที่รันบน Linux และ Docker ระบบวางแผนส่งข้อมูลใบงานเข้าไปแล้วได้ผลทำนายกลับมา และมีแอป Android ที่ทำงานได้แม้ไม่มีสัญญาณ
หน้าจอจัดลำดับแสดงใบงานที่รอเข้าเครื่อง เรียงตามคำแนะนำของโมเดล คู่กับสถานะเครื่องที่กำลังผลิต คนวางแผนยังเป็นคนตัดสินใจสุดท้าย และทุกครั้งที่ผลจริงต่างจากที่ทำนาย ข้อมูลนั้นจะกลับไปเป็นชุดฝึกรอบใหม่
แนวทางที่อยากเผยแพร่
- เริ่มจากปัญหาหน้างานที่วัดได้ ไม่ใช่จากอัลกอริทึมที่อยากลอง
- ใช้ข้อมูลที่โรงงานมีอยู่แล้ว ข้อมูลประวัติการผลิตสองปีมีค่ามากกว่าที่คิด
- วัดให้ครบ โดยเฉพาะเมื่อข้อมูลไม่สมดุล ความถูกต้องอย่างเดียวหลอกตาได้
- ทำให้รันซ้ำได้อัตโนมัติ เพื่อฝึกใหม่เมื่อสายการผลิตเปลี่ยน
- นำไปไว้ในระบบที่คนใช้อยู่แล้ว ผ่าน API และให้คนตัดสินใจคนสุดท้าย
ข้อควรระวัง ความแม่นยำสูงขนาดนี้เกิดจากกระบวนการที่มีรูปแบบค่อนข้างคงที่ ถ้าเปลี่ยนรุ่นสินค้าหรือเพิ่มเครื่องใหม่ ต้องเฝ้าดูความแม่นยำและฝึกโมเดลใหม่เป็นระยะ รายละเอียดของบริษัทเป็นความลับ ภาพหน้าจอในบทความนี้จึงเป็นภาพแนวคิด
อ้างอิง
พิศาล บุญหนัก และ วฤษาย์ ร่มสายหยุด. (2570). การจัดการใบสั่งงานเชิงทำนายสำหรับกระบวนการผลิตเซมิคอนดักเตอร์โดยใช้อัลกอริธึมป่าสุ่ม. วารสารเทคโนโลยีสารสนเทศ มจพ., 23(1). (รับตีพิมพ์แล้ว)